







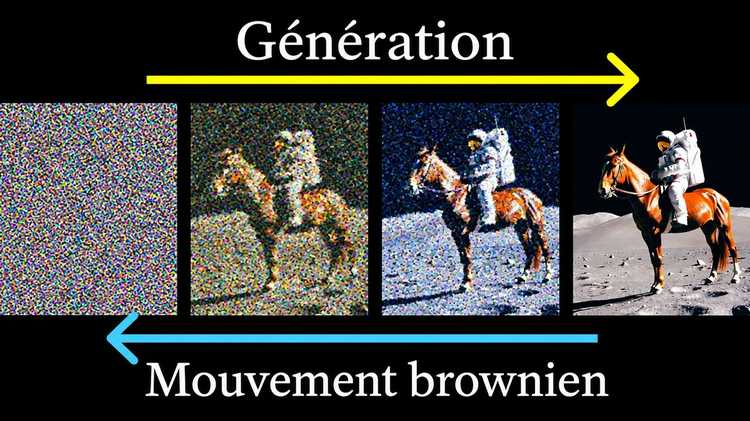
Ces dernières années, les systèmes d’intelligence artificielle sont devenus étonnamment performants pour transformer de simples descriptions textuelles en vidéos d’un réalisme saisissant. Au cœur de cette prouesse technologique se cache un lien profond avec la physique. Cette génération de modèles repose sur un processus dit de diffusion, remarquablement équivalent au mouvement brownien que l’on observe dans le déplacement des particules, mais s’opérant à rebours dans le temps et au sein d’un espace mathématique de très grande dimension.
L’application concrète de ces principes physiques donne naissance à des algorithmes puissants. Si l’on observe un modèle open source performant comme Wan2.1, la création d’une vidéo commence toujours par un appel à un générateur de nombres aléatoires. L’IA génère d’abord une vidéo composée de pur bruit, semblable à la neige d’un vieux téléviseur. Cette bouillie de pixels est ensuite passée dans un réseau de type Transformer, similaire à l’architecture de ChatGPT. Au fil de dizaines d’itérations successives, le modèle sculpte littéralement ce bruit aléatoire pour en faire émerger une structure cohérente, transformant le chaos en une vidéo incroyablement détaillée correspondant au texte demandé.
CLIP : le pont mathématique entre les mots et les images
Pour comprendre comment l’IA parvient à lier si intimement le texte à l’image, il faut remonter à février 2021, avec la publication par OpenAI d’une architecture révolutionnaire baptisée CLIP. Entraîné sur 400 millions de paires image-légende issues d’Internet, CLIP se compose en réalité de deux modèles distincts : l’un traite le texte, l’autre la vision.
L’objectif de CLIP est de projeter les images et leurs descriptions dans un espace mathématique commun, appelé espace latent ou d’embedding, sous la forme de vecteurs de 512 dimensions. L’entraînement repose sur une approche dite contrastive : le système apprend à maximiser la similarité (mesurée par la similarité cosinus) entre le vecteur d’une image et celui de sa légende exacte, tout en minimisant la similarité avec toutes les autres légendes du lot de données.
La géométrie de cet espace vectoriel partagé possède des propriétés fascinantes. Il devient possible d’opérer mathématiquement sur des concepts purs. Le vulgarisateur Stephen Welch en donne un exemple frappant : en prenant le vecteur d’une photo de lui portant un chapeau, et en y soustrayant le vecteur d’une photo de lui sans chapeau, on obtient un nouveau vecteur. En comparant ce vecteur mathématique au dictionnaire du modèle texte, la meilleure correspondance obtenue est le mot « chapeau », suivi de « casquette ». L’IA a ainsi appris à traduire la présence visuelle d’un objet en une distance géométrique entre des vecteurs.
DDPM et modèles de diffusion : remonter le temps du bruit
Si CLIP permet de comprendre le contenu, il ne permet pas de générer de nouvelles images. C’est là qu’interviennent les modèles probabilistes de diffusion de débruitage (DDPM), introduits par des chercheurs de Berkeley en 2020.
Le principe fondamental consiste à prendre des images réelles et à y ajouter progressivement du bruit aléatoire jusqu’à leur destruction totale. Un réseau de neurones est ensuite entraîné à inverser ce processus. Contrairement à l’intuition première, le modèle n’apprend pas à retirer le bruit étape par étape. Il est entraîné à prédire, en une seule fois, la totalité du bruit qui a été ajouté à l’image d’origine. Le modèle apprend ainsi un champ vectoriel dynamique, conditionné par le temps, qui pointe toujours dans la direction de la distribution des données réelles.
Pour visualiser ce concept, on peut imaginer que toutes les images réalistes forment une forme de spirale dans un espace en deux dimensions. Ajouter du bruit à une image revient à faire une marche aléatoire (un mouvement brownien) qui l’éloigne de cette spirale. Lors de la génération, le modèle part d’un point aléatoire dans l’espace et suit son champ vectoriel pour retourner vers la spirale des images réelles.
Cependant, l’algorithme DDPM original exige d’ajouter artificiellement du bruit aléatoire à chaque étape de la génération, même en phase de débruitage. Sans cet ajout constant de bruit, toutes les trajectoires convergent vers le centre exact de la spirale, c’est-à-dire vers la moyenne mathématique de toutes les images du jeu de données. Dans l’espace visuel, une moyenne se traduit par une image floue et sans détails. L’injection de bruit force les trajectoires à se disperser et à atterrir sur des points spécifiques de la spirale, générant ainsi des images nettes et variées.
DDIM : l’accélération mathématique
Le principal défaut de l’approche DDPM résidait dans sa lenteur, nécessitant des centaines de passages dans le réseau de neurones. Quelques mois plus tard, des chercheurs de Stanford et de Google ont démontré qu’il était possible de s’affranchir de l’ajout de bruit aléatoire lors de la génération. En s’appuyant sur des concepts de mécanique statistique, ils ont traduit l’équation différentielle stochastique du modèle en une équation différentielle ordinaire.
Cette méthode, baptisée DDIM, modifie l’échelle et la taille des pas effectués par le modèle lors du retour vers la spirale des données. Elle permet aux trajectoires de suivre parfaitement les lignes de courant du champ vectoriel appris, atterrissant proprement sur des images réalistes de manière entièrement déterministe, et ce, en un nombre d’étapes drastiquement réduit.
Le guidage sans classificateur : sculpter l’image avec les mots
Il restait à unir la compréhension sémantique de CLIP à la puissance générative de la diffusion. En 2022, avec des modèles comme DALL-E 2, les chercheurs ont commencé à conditionner les modèles de diffusion en leur injectant les vecteurs textuels. Le modèle sait alors qu’il doit débruiter l’image en tenant compte du contexte fourni par le texte.
Pourtant, le simple conditionnement s’avère insuffisant pour obtenir une correspondance parfaite avec le prompt. Si l’on demande un arbre dans un désert, le modèle peut générer un désert avec une simple ombre, la tâche globale de générer une image réaliste prenant le pas sur la consigne spécifique.
La solution définitive s’appelle le guidage sans classificateur (Classifier-Free Guidance). La technique consiste à calculer deux champs vectoriels distincts lors de la génération :
- Un vecteur non conditionné (le modèle génère une image au hasard, sans consigne).
- Un vecteur conditionné (le modèle génère une image en suivant le prompt).
L’algorithme soustrait le vecteur non conditionné du vecteur conditionné. La différence obtenue isole la direction mathématique pure du concept demandé (l’arbre). Ce vecteur de différence est ensuite multiplié par un facteur d’échelle (alpha) pour amplifier artificiellement la direction du prompt, forçant littéralement les pixels à se conformer à la demande textuelle. Plus le facteur alpha est élevé, plus l’arbre apparaît grand et détaillé dans l’image finale.
Cette logique s’applique même à l’envers grâce aux prompts négatifs. Au lieu de soustraire un vecteur vide, des modèles comme Wan2.1 soustraient un vecteur correspondant à des concepts indésirables (comme « doigts en trop » ou « marcher à reculons »), orientant ainsi la diffusion à l’opposé de ces défauts pour garantir une anatomie et une physique cohérentes.
L’assemblage de ces briques fondamentales — la géométrie sémantique de CLIP, la modélisation du mouvement brownien par la diffusion, et l’amplification vectorielle du guidage — a donné naissance à une classe de machines fondamentalement nouvelle. Des systèmes capables de matérialiser l’imagination humaine à partir du néant, où la maîtrise des mathématiques de haute dimension remplace désormais la caméra et le pinceau.
Source : 3Blue1Brown